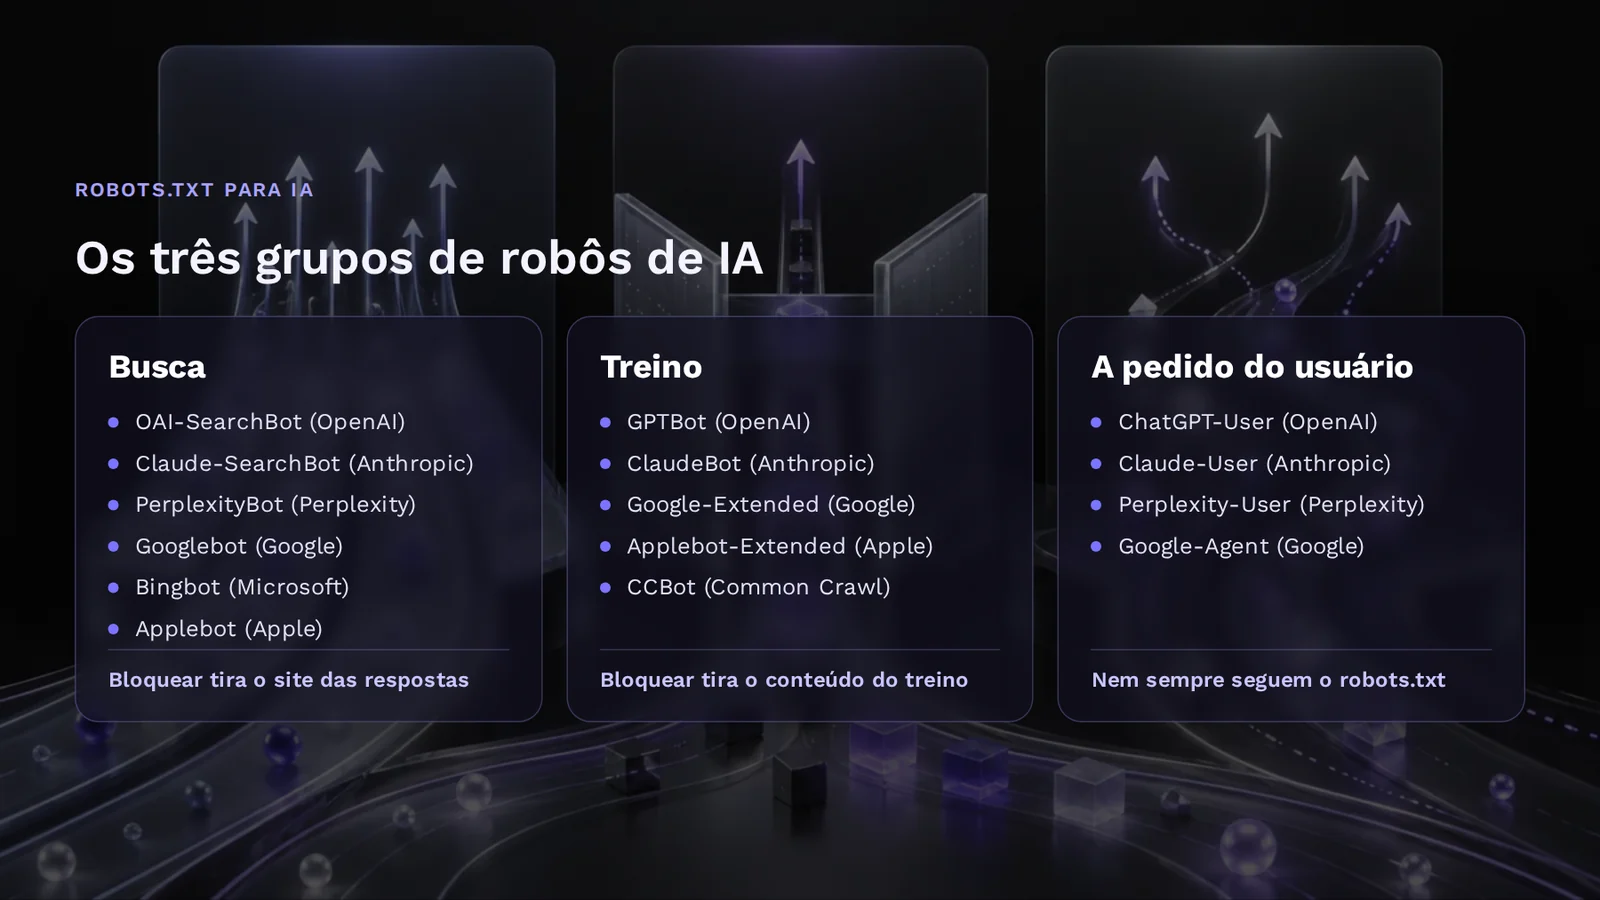
Acertar o robots.txt para IA começa por uma distinção que quase ninguém explica: cada empresa de IA tem robôs diferentes para treinar modelos e para buscar respostas. Bloquear o GPTBot tira o seu conteúdo do treino da OpenAI sem tirar o site do ChatGPT, enquanto bloquear o OAI-SearchBot tira o site das respostas com busca, e a lógica se repete, com outros nomes, na Anthropic, na Perplexity, no Google e na Apple. E o bloqueio pode nem estar no arquivo que você escreveu, porque a Cloudflare grava no robots.txt o que foi escolhido no painel dela, e firewall ou plugin de segurança também barram robôs.
Abaixo estão a tabela robô por robô, o que mudou na Cloudflare, um roteiro de conferência e exemplos comentados. Liberar os robôs certos é o primeiro item de qualquer trabalho de AEO (otimização para mecanismos de resposta) e de GEO (otimização para IA generativa), mas sozinho não garante nada: só permite que o site seja lido, e o resto está no guia de SEO para IA.
Neste artigo
Treinar não é buscar: os dois trabalhos dos robôs de IA
O robots.txt é um arquivo de texto na raiz do site em que você diz o que cada robô pode visitar, chamando cada um pelo nome com que ele se apresenta, o user agent. É um pedido, e não uma tranca: a especificação oficial do protocolo, a RFC 9309, diz que as regras não são autorização de acesso, e o Google lembra que cabe ao robô obedecer.
O robô de treino coleta páginas que podem entrar no aprendizado dos próximos modelos, que é o que a IA usa quando responde sem pesquisar. O robô de busca visita páginas para que o assistente as encontre e cite com link quando a pergunta pede informação atual. Bloquear o primeiro é decidir sobre o uso do seu conteúdo, enquanto bloquear o segundo é decidir se o site aparece nas respostas.
Google e Apple usam o mesmo robô para busca e treino, e oferecem um nome à parte (Google-Extended e Applebot-Extended) só para você recusar o treino. A documentação da OpenAI resume a lógica: as configurações são independentes, e dá para liberar o OAI-SearchBot e bloquear o GPTBot.
A tabela dos robôs de IA, robô por robô
Conferida na documentação oficial de cada empresa em 27/09/2026. O nome da primeira coluna é o que vai na linha User-agent: do robots.txt.
Robôs de busca: levam o site às respostas
| Robô | De quem é | Para que serve | Se você bloquear |
|---|---|---|---|
| OAI-SearchBot | OpenAI | Respostas com busca do ChatGPT | O site sai dessas respostas e pode sobrar só como link de navegação; a mudança leva cerca de 24 horas |
| Claude-SearchBot | Anthropic | Resultados de busca do Claude | Pode reduzir a visibilidade e a precisão do site nessas respostas |
| PerplexityBot | Perplexity | Resultados do Perplexity; a empresa diz que não o usa para treino | O site pode deixar de aparecer no Perplexity |
| Googlebot | Toda a Pesquisa Google, inclusive AI Overviews e Modo IA | O site some da busca ou fica só com o endereço, e sai dos recursos de IA do Google | |
| Bingbot | Microsoft | Busca do Bing; sem marcação em contrário, o conteúdo pode ir para as respostas com IA e o treino da Microsoft | O site sai do Bing; para ficar no Bing e fora da IA, a Microsoft indica a meta tag NOARCHIVE |
| Applebot | Apple | Busca na Siri, no Spotlight e no Safari; os dados também podem treinar modelos da Apple | O site pode sair dessas buscas; sem regra própria para o Applebot, a Apple segue a do Googlebot |
Robôs e controles de treino
| Robô | De quem é | Para que serve | Se você bloquear |
|---|---|---|---|
| GPTBot | OpenAI | Treino dos modelos da OpenAI | O conteúdo fica fora do treino; o site segue podendo aparecer no ChatGPT |
| ClaudeBot | Anthropic | Treino dos modelos da Anthropic | O material futuro do site fica fora do treino |
| Google-Extended | Não é um robô: decide se o que o Google coleta treina o Gemini e embasa respostas do app Gemini e da Vertex AI | Fica fora desse uso; o Google diz que não afeta inclusão nem ranking na Pesquisa Google | |
| Applebot-Extended | Apple | Não visita páginas: decide se o que o Applebot coletou treina modelos da Apple | Fica fora do treino e segue na busca da Apple, sem efeito no ranking |
| CCBot | Common Crawl | Arquivo aberto da web, gratuito para pesquisa e análise | O site sai das próximas coletas; não é robô de busca de nenhuma IA |
Para ver como esses robôs entram no resto do trabalho de ser encontrado pela OpenAI, leia o guia sobre como aparecer no ChatGPT.
O bloqueio que você não vê: Cloudflare, firewall e plugin
Em 21/08/2026 a Cloudflare lançou o Bot Preference Sync, que grava no robots.txt as escolhas feitas no painel de robôs de IA. Ele vem ligado por padrão para clientes novos, em todos os planos, e acrescenta um bloco no começo do arquivo, sem apagar o que existia, então o seu robots.txt pode dizer não a algum robô sem que ninguém tenha editado o arquivo.
Em 15/09/2026 veio a segunda mudança. O painel passou a separar busca, treino e agente, e ganhou a opção “Disallow AI Training”, que grava no robots.txt o pedido para não treinar, mantém liberados para a busca os robôs que a Cloudflare chama de responsáveis (“Accountable”) e bloqueia quem ignora o pedido. A lista inclui Apple, Google e Microsoft, cujos robôs fazem busca e treino juntos, e Amazon, Anthropic, Meta e OpenAI, que separam as duas coisas. A opção antiga “Block AI bots” está sendo descontinuada, e quem bloqueava o treino passa para “Disallow AI Training”.
Para domínio novo, a Cloudflare passou a oferecer no cadastro uma configuração pronta que depende de uma pergunta: se o site ganha dinheiro com anúncios. Se a resposta é sim, a busca fica liberada, o treino vai para “Disallow AI Training” e os agentes (robôs que visitam a página em nome de uma pessoa) ficam bloqueados nas páginas com anúncio. Quem cadastrou o domínio, seja a agência, o desenvolvedor ou você num clique rápido, pode ter aceitado essa recomendação sem que mais ninguém saiba.
O ponto que mais pede atenção é outro: desde 15/09, escolher “Block” ou “Block on pages with ads” no treino também bloqueia Googlebot, Bingbot e Applebot, e a Cloudflare avisa que isso afeta a busca, e não só o treino. Para ficar só fora do treino, a opção é “Disallow AI Training”, lembrando que, segundo a Cloudflare, a previsão para o Bingbot ler esse pedido no robots.txt é o começo de 2027.
Fora da Cloudflare, o bloqueio pode estar no firewall da hospedagem, na rede de entrega de conteúdo (CDN) ou num plugin de segurança que barra robôs pelo nome ou pelo endereço IP, e aí o robots.txt diz “pode entrar” enquanto a porta continua fechada. A ajuda do ChatGPT pede que a hospedagem ou a CDN aceite os endereços IP que a OpenAI publica para o robô de busca, e a Perplexity avisa que quem usa firewall de aplicação pode precisar liberar os robôs dela de forma explícita.
Robôs que ignoram o robots.txt
Os robôs acionados por uma pessoa seguem outra lógica: como o pedido partiu de alguém, OpenAI, Google e Perplexity avisam que o robots.txt pode não valer para eles. A Anthropic é a exceção, porque diz que todos os robôs dela respeitam o arquivo.
| Robô | De quem é | Para que serve | E o robots.txt? |
|---|---|---|---|
| ChatGPT-User | OpenAI | Abre páginas a pedido de quem usa o ChatGPT | A OpenAI avisa que as regras podem não valer |
| Claude-User | Anthropic | Busca páginas para responder a quem usa o Claude | Respeita; bloquear pode reduzir a visibilidade nas buscas pedidas pelo usuário |
| Perplexity-User | Perplexity | Abre páginas quando a pergunta do usuário pede | Em geral ignora |
| Google-Agent e Google-GeminiNotebook | Agentes a pedido do usuário e links que ele indica como fonte | Em geral ignoram |
Na prática, o robots.txt não protege conteúdo: o que precisa ficar fechado pede senha, como recomenda a própria especificação, e a página que não deve aparecer nem como link no ChatGPT pede a meta tag noindex, indicada pela OpenAI, que o robô precisa conseguir abrir para ler.
Como conferir o seu robots.txt para IA em 2 minutos
Os quatro primeiros passos cabem em dois minutos, e o quinto depende de quem cuida do site.
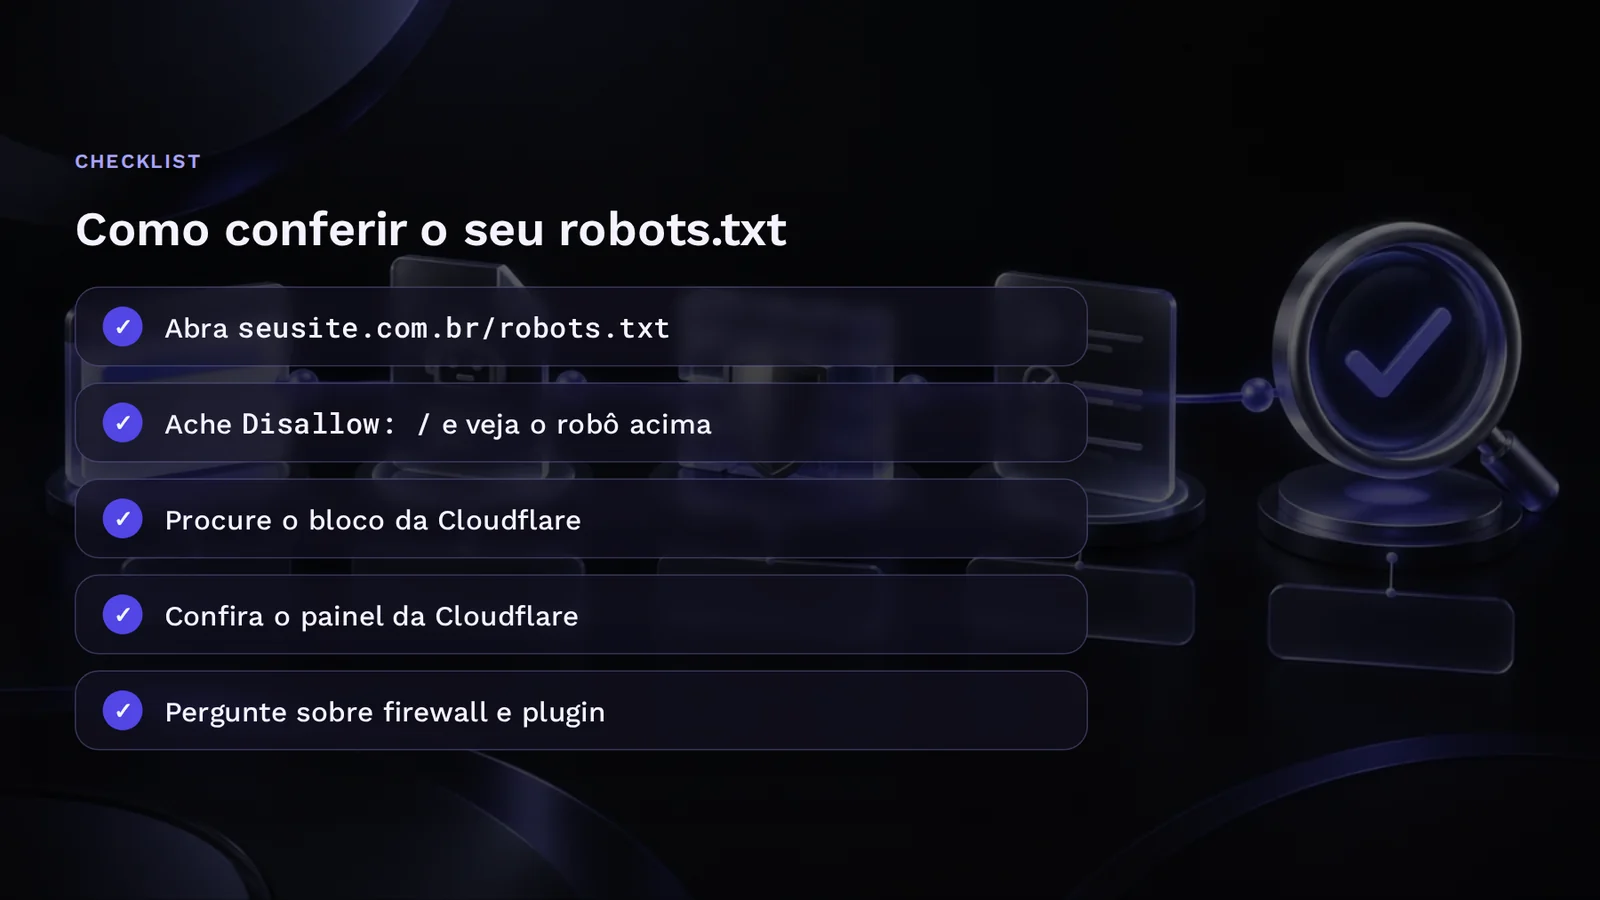
- Abra o arquivo digitando o endereço do site seguido de /robots.txt. Se ele não existir, o Google trata o site como sem restrições; se der erro de servidor, o Google para de rastrear o site nas primeiras 12 horas, o que é um problema maior do que qualquer robô de IA.
- Procure
Disallow: /e olhe oUser-agentlogo acima. Robô de busca da tabela significa site fora daquela busca; robô ou controle de treino é decisão só sobre treino;User-agent: *vale para todo robô que não tenha grupo com o próprio nome. - Procure a marca da Cloudflare. Um bloco que começa com
# BEGIN Cloudflare Bot Preference Syncvem do painel da Cloudflare, e é lá que a mudança precisa ser feita. - Se o site usa Cloudflare, abra o painel em Security Settings, na configuração de robôs de IA, e confira a busca em “Allow” e o treino em “Disallow AI Training” (se você não quer o conteúdo no treino), nunca em “Block”.
- Confirme com quem cuida do site se há regra de firewall, CDN ou plugin bloqueando robôs por nome ou por IP. No Search Console, o relatório de robots.txt mostra a versão que o Google leu e quando.
Exemplos de configuração comentados
Três regras da especificação, como o Google a descreve, explicam quase todos os erros num robots.txt para IA: cada robô segue só o grupo com o nome dele e ignora o do asterisco quando tem grupo próprio; vários User-agent podem dividir o mesmo grupo; e o arquivo vale só para o endereço exato, então www.seusite.com.br e seusite.com.br precisam de arquivos próprios. Linhas que começam com # são comentários.
Ficar nas buscas e fora do treino
# Treino: pedir para não usar o conteúdo
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Google-Extended
User-agent: Applebot-Extended
Disallow: /

# Todos os outros robôs, inclusive os de busca,
# seguem liberados, menos na área restrita
User-agent: *
Disallow: /area-restrita/

Sitemap: https://www.seusite.com.br/sitemap.xml
Para bloquear o GPTBot sozinho, bastam as linhas User-agent: GPTBot e Disallow: /, e o ChatGPT continua podendo mostrar o site pelo OAI-SearchBot. O Bingbot fica de fora de propósito, porque bloqueá-lo tiraria o site do Bing, e a Microsoft trata o uso em IA pelas meta tags NOARCHIVE e NOCACHE, descritas pelo Bing.
Fechado para robôs desconhecidos, aberto para as buscas
# Buscas liberadas, menos na área restrita
User-agent: Googlebot
User-agent: Bingbot
User-agent: Applebot
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
Disallow: /area-restrita/

# Controles de treino do Google e da Apple
User-agent: Google-Extended
User-agent: Applebot-Extended
Disallow: /

# Todo o resto fica fora, inclusive robôs de treino
User-agent: *
Disallow: /
É o modelo mais fechado, e cobra manutenção, porque robô de busca novo cai no bloqueio geral até alguém acrescentar o nome dele. A área restrita aparece repetida no grupo das buscas porque esses robôs não leem o grupo do asterisco.
O erro que tira o site de tudo
User-agent: *
Disallow: /
Essas duas linhas fecham o site para todo robô que respeita o arquivo, inclusive Googlebot, Bingbot e OAI-SearchBot, e podem sobrar de quando o site estava em construção. O sintoma nem sempre é o sumiço completo, porque o Google lembra que uma página bloqueada ainda pode aparecer só com o endereço quando outros sites apontam para ela.
Perguntas frequentes
Bloquear o GPTBot tira meu site do ChatGPT?
Não. O GPTBot coleta conteúdo para o treino dos modelos da OpenAI, e bloqueá-lo diz que o seu conteúdo não deve ser usado nesse treino. Quem leva o site às respostas com busca do ChatGPT é o OAI-SearchBot, e a OpenAI deixa claro que as duas configurações são independentes: dá para liberar um e bloquear o outro no mesmo robots.txt.
O que acontece se eu bloquear o OAI-SearchBot?
O site deixa de aparecer nas respostas com busca do ChatGPT, e a OpenAI diz que ele ainda pode surgir como link de navegação, só com endereço e título, quando ela conhece a página por outros caminhos. Para não aparecer nem assim, a indicação é a meta tag noindex. A OpenAI calcula cerca de 24 horas para uma mudança no robots.txt valer na busca.
A Cloudflare está bloqueando o meu site nas IAs?
Depende da configuração. Desde 15/09/2026, domínio novo recebe no cadastro uma configuração recomendada que, para site com anúncios, pede às IAs para não treinar e bloqueia agentes nas páginas com anúncio, deixando a busca liberada. O risco maior é escolher “Block” no treino, que desde a mesma data também bloqueia Googlebot, Bingbot e Applebot. Confira o painel e o bloco da Cloudflare no seu robots.txt.
Dá para ficar no Google e fora do treino do Gemini?
Sim. O Google-Extended não é um robô, é um nome que você bloqueia no robots.txt para dizer que o conteúdo coletado pelo Google não deve treinar os modelos Gemini nem servir de base para respostas em produtos como o app Gemini. O Google diz que isso não afeta a inclusão nem o ranking na Pesquisa Google, e o AI Overviews e o Modo IA seguem as regras do Googlebot.
O robots.txt impede que a IA leia a minha página?
Não com certeza. O robots.txt é um pedido que os robôs documentados dizem respeitar, e não uma tranca: a especificação diz que ele não é autorização de acesso. Robôs acionados por uma pessoa, como o ChatGPT-User e o Perplexity-User, podem não seguir o arquivo. Para conteúdo que não pode ser lido, use senha; para página que não deve aparecer, use noindex.
Preciso de llms.txt para liberar as IAs?
Não. Quem diz o que cada robô pode visitar é o robots.txt. O llms.txt é uma proposta de arquivo, de 2024, que resume o site para agentes de IA, e o guia do Google diz que a Pesquisa Google ignora esse tipo de arquivo, então lá ele não ajuda nem atrapalha. Explicamos quando ele vale a pena no guia sobre llms.txt.
Liberou os robôs certos? O próximo passo é saber como as IAs leem o resto do site e o que melhorar primeiro. Faça sua análise grátis